แบบฝึกหัดในคาบ + เฉลย
วิชานี้ไม่มีข้อสอบเก่า — ที่รวมไว้นี่คือแบบฝึกหัดและงานในคาบของเทอมนี้ทั้งหมดก่อนกลางภาค บวกโจทย์ที่แต่งเพิ่มตามหัวข้อที่อาจารย์ประกาศไว้ในสโคปสอบ กดที่หัวข้อเพื่อดูเฉลย — ลองทำเองก่อนเปิดดูเสมอ
2. Fill-in-the-code — เติมหรือเขียนโค้ดให้สมบูรณ์
3. Problem-solving scenarios — โจทย์สถานการณ์ที่ต้องประยุกต์ใช้แนวคิดในวิชา
เขียนตัวใหญ่ ๆ ชัด ๆ ด้วยปากกาน้ำเงินหรือดำ · ตรวจก่อนส่งว่าอ่านออก
AIntroduction to Databases
A1. อธิบายข้อเสียของการใช้ file system เก็บข้อมูล มาอย่างน้อย 5 ข้อ พร้อมยกตัวอย่าง
- Data redundancy and inconsistency — ไฟล์หลายรูปแบบ ข้อมูลชุดเดียวถูกเก็บซ้ำในหลายไฟล์ · เช่น ที่อยู่ลูกค้าอยู่ทั้งในไฟล์การขายและไฟล์การจัดส่ง แก้ที่หนึ่งลืมอีกที่
- Difficulty in accessing data — ทุกคำถามใหม่ต้องเขียนโปรแกรมใหม่
- Data isolation — ข้อมูลกระจายอยู่หลายไฟล์หลายฟอร์แมต
- Integrity problems — กฎเช่น “ยอดคงเหลือ > 0” ถูกฝังในโค้ด ไม่ได้ประกาศชัดเจน แก้กฎยาก
- Atomicity of updates — ระบบล่มกลางคัน ทำให้ข้อมูลค้างครึ่ง ๆ กลาง ๆ · เช่น โอนเงินแล้วหักออกสำเร็จแต่ยังไม่ทันเพิ่มปลายทาง
- Concurrent access anomalies — สองคนอ่านยอด 100 พร้อมกัน ต่างคนต่างถอน 50 ควรเหลือ 0 แต่กลับเหลือ 50
- Security problems — ให้ผู้ใช้เห็นข้อมูลบางส่วนแต่ไม่ทั้งหมดได้ยาก · OS ให้แค่รหัสผ่านซึ่งยืดหยุ่นไม่พอ
A2. อธิบาย three levels of abstraction และ physical data independence
Physical level — อธิบายว่า record ถูกเก็บอย่างไร (ไฟล์ บล็อก index บนดิสก์)
Logical level — อธิบายว่าเก็บข้อมูลอะไรและข้อมูลสัมพันธ์กันอย่างไร คือ schema
View level — ส่วนของฐานข้อมูลที่แอปหนึ่ง ๆ เห็น ซ่อนรายละเอียดชนิดข้อมูล และซ่อนข้อมูลเช่นเงินเดือนเพื่อความปลอดภัย
Physical data independence = ความสามารถในการแก้ physical schema โดยไม่ต้องแก้ logical schema
เพราะแอปพลิเคชันผูกกับ logical schema การเปลี่ยนวิธีจัดเก็บบนดิสก์จึงไม่กระทบโปรแกรม
โดยทั่วไปอินเทอร์เฟซระหว่างชั้นและระหว่างองค์ประกอบต่าง ๆ ต้องนิยามให้ชัด เพื่อให้การเปลี่ยนแปลงบางส่วนไม่กระทบส่วนอื่นอย่างรุนแรง
A3. schema กับ instance ต่างกันอย่างไร · ถ้าเพิ่มนักศึกษา 1 คน อะไรเปลี่ยน
Schema = โครงสร้างเชิงตรรกะโดยรวมของฐานข้อมูล เทียบได้กับ type ในภาษาโปรแกรม · เปลี่ยนไม่บ่อย
Instance = เนื้อหาจริงของฐานข้อมูล ณ จุดเวลาหนึ่ง เทียบได้กับ value ของตัวแปร · เปลี่ยนตลอดเวลา
เพิ่มนักศึกษา 1 คน → instance เปลี่ยน · schema ไม่เปลี่ยน เพราะโครงสร้างคอลัมน์ยังเหมือนเดิมทุกประการ
A4. องค์ประกอบของ database engine มีอะไรบ้าง แต่ละส่วนทำอะไร
1. Storage manager — โมดูลที่เป็นตัวกลางระหว่างข้อมูลระดับล่างในฐานข้อมูล กับโปรแกรมและ query ที่ส่งเข้ามา · รับผิดชอบการติดต่อกับ file manager ของ OS และการจัดเก็บ/ดึง/อัปเดตข้อมูลอย่างมีประสิทธิภาพ · ประเด็นที่เกี่ยวข้อง: storage access, file organization, indexing และ hashing
2. Query processor — ทำ 3 ขั้น: (1) parsing and translation (2) optimization (3) evaluation · query เดียวกันประเมินได้หลายวิธี (นิพจน์ที่สมมูลกัน และอัลกอริทึมที่ต่างกันสำหรับแต่ละ operation) ความต่างของต้นทุนระหว่างวิธีที่ดีกับแย่นั้นมหาศาล จึงต้องประมาณต้นทุนโดยอาศัยข้อมูลสถิติของ relation
3. Transaction manager — transaction คือกลุ่มของ operation ที่ทำหน้าที่เชิงตรรกะหนึ่งอย่าง · transaction-management component รักษาให้ฐานข้อมูลอยู่ในสถานะที่ถูกต้องแม้เกิด system failure หรือ transaction failure · concurrency-control manager ควบคุมการทำงานร่วมกันของ transaction ที่รันพร้อมกัน
A5. NoSQL กับ NewSQL ต่างกันอย่างไร ควรเลือกใช้ NoSQL เมื่อไหร่
NoSQL — key-value store และ document-oriented database ที่เร็ว · ไม่ต้องมี schema ตายตัว · เลี่ยง join ด้วยการเก็บข้อมูลแบบ denormalized · ออกแบบให้ scale แนวนอน · ตัวอย่าง MongoDB (document), Cassandra (column-family), Neo4j (graph), Redis (key-value)
เลือก NoSQL เมื่อ แอปต้องการ horizontal scalability · schema ยืดหยุ่นหรือเปลี่ยนไปเรื่อย ๆ · ต้องจัดการข้อมูลไร้โครงสร้างปริมาณมหาศาลที่ตาราง relational จำลองได้ไม่มีประสิทธิภาพ
NewSQL — RDBMS สมัยใหม่ที่รวมความสามารถในการขยายและความยืดหยุ่นของ NoSQL เข้ากับการรับประกัน ACID และความเข้ากันได้กับ SQL ของ RDBMS ดั้งเดิม · คุณสมบัติหลัก: horizontal scalability, strong consistency, SQL compatibility, high performance · ตัวอย่าง Google Spanner, CockroachDB
BRelational Model & Keys
B1. ให้ Student(student_id, national_id, email, full_name) โดยสามคอลัมน์แรกไม่ซ้ำ · ระบุ superkey ทั้งหมด candidate key และเลือก primary key พร้อมเหตุผล
Superkeys — เซตใดก็ตามที่มี candidate key อยู่ข้างใน:
{student_id}, {national_id}, {email}, {student_id, full_name}, {student_id, email}, {national_id, email},
{student_id, national_id, email, full_name} … รวมทุกเซตที่มี student_id หรือ national_id หรือ email อยู่
Candidate keys — superkey ที่ minimal: {student_id}, {national_id}, {email}
Primary key = student_id · เหตุผล: ระบบมหาวิทยาลัยออกให้และรับประกันว่าไม่ซ้ำ · email เปลี่ยนได้ จึงไม่เหมาะเป็น PK (PK ควรเป็นค่าที่ไม่เคยหรือแทบไม่เคยเปลี่ยน) · national_id มีประเด็นความเป็นส่วนตัว
{full_name} ไม่ใช่แม้แต่ superkey เพราะคนชื่อซ้ำกันได้
B2. {student_id, national_id} เป็น superkey หรือ candidate key · อธิบายความต่าง
เป็น superkey แต่ไม่ใช่ candidate key
เป็น superkey เพราะระบุ tuple ได้เฉพาะตัว (ถ้า K เป็น superkey แล้ว superset ของ K ก็เป็น superkey)
ไม่ใช่ candidate key เพราะไม่ minimal — ตัด national_id ทิ้งแล้ว {student_id} เพียงตัวเดียวก็ยังระบุ tuple ได้เฉพาะตัว
นิยาม candidate key = minimal superkey คือ superkey ที่ไม่มีสับเซตแท้ตัวใดเป็น superkey
B3. อธิบาย foreign key constraint · ทำไม INSERT INTO Enrollment VALUES ('9999999999','EN813304','1',2026,'A') ถึงล้มเหลว
Foreign key = attribute ใน relation r₁ ที่ค่าต้องปรากฏเป็นค่า primary key ของ tuple ใด tuple หนึ่งใน relation r₂ · r₁ = referencing relation · r₂ = referenced relation
FK constraint ทำสองอย่าง: (1) ป้องกันการกระทำที่จะทำลายลิงก์ระหว่างตาราง (2) ป้องกันการใส่ข้อมูลที่ไม่ถูกต้องลงคอลัมน์ FK
INSERT นี้ล้มเหลว เพราะ student_id = '9999999999' ไม่มีอยู่ในตาราง Student
ซึ่งละเมิด foreign key constraint FOREIGN KEY (student_id) REFERENCES Student(student_id)
MySQL ตอบว่า: Cannot add or update a child row: a foreign key constraint fails
นี่คือการทำงานของ referential integrity
B4. ทำไม PK ของ Enrollment ต้องเป็น (student_id, course_id, semester, year) · student_id เดี่ยว ๆ ไม่ได้เหรอ
student_id เดี่ยว ๆ เป็น PK ไม่ได้ เพราะนักศึกษาหนึ่งคนลงทะเบียนได้หลายวิชา เช่นในข้อมูลมี ('6401001001','EN813304',…) และ ('6401001001','EN813201',…) → ค่า student_id ซ้ำกัน จึงระบุ tuple ไม่ได้เฉพาะตัว
ต้องมี semester และ year ด้วย เพราะนักศึกษาคนเดิมลงวิชาเดิมซ้ำได้ในภาคเรียนหรือปีต่างกัน (เช่น ตกแล้วลงใหม่)
คำถามต่อ: (student_id, course_id, semester, year, grade) เป็น superkey แต่ไม่ใช่ candidate key เพราะตัด grade ออกได้แล้วยังระบุได้เฉพาะตัว
CRelational Algebra
ใช้ schema: Student(student_id, name, major, gpa) · Course(course_id, title, credits, dept_name) ·
Enrollment(student_id, course_id, semester, year, grade)
ทบทวนสัญลักษณ์ก่อนทำ —
σ (sigma) = select กรองแถว · Π (pi) = project เลือกคอลัมน์ แล้วตัดแถวซ้ำอัตโนมัติ ·
× = Cartesian product จับคู่ทุกแถว · ⋈ = natural join จับคู่เฉพาะที่ตรงกัน ·
∪ ∩ − = union / intersect / difference · ρ (rho) = rename ·
∧ ∨ ¬ = and / or / not
ทบทวนบทที่ 3 แบบเต็ม
C1. เขียนนิพจน์: หารายวิชาทั้งหมดของภาค CoE ที่มี 3 หน่วยกิต
σ dept_name='CoE' ∧ credits=3 (Course)เขียนแบบซ้อนกันก็สมมูลกัน: σ dept_name='CoE' ( σ credits=3 (Course) )
C2. เขียนนิพจน์: หา course_id ที่มีการลงทะเบียนปี 2026 แต่ไม่มีปี 2025
Π course_id ( σ year=2026 (Enrollment) )
   −
Π course_id ( σ year=2025 (Enrollment) )
ต้อง Π ก่อน − เพราะ set difference ต้องการ arity เท่ากันและ domain เข้ากันได้
C3. เขียนนิพจน์: หาชื่อนักศึกษาที่ลงทะเบียนวิชา 'EN813304'
Π name ( Student ⋈ σ course_id='EN813304' (Enrollment) )เขียนด้วย operator พื้นฐานล้วน:
Π name ( σ Student.student_id = Enrollment.student_id
       ( Student × σ course_id='EN813304' (Enrollment) ) )
C4. คู่นี้สมมูลกันหรือไม่ · Πname(σgpa>3.0(S)) vs σgpa>3.0(Πname(S))
ไม่สมมูลกัน · นิพจน์ที่สองทำ Πname ก่อน ซึ่งตัดคอลัมน์ gpa ทิ้งไปแล้ว
จากนั้นจึงพยายามกรองด้วย gpa > 3.0 บน relation ที่ไม่มี attribute ชื่อ gpa เหลืออยู่ → นิพจน์นี้ไม่ถูกต้อง (invalid)
บทเรียน: จะ push σ ลงไปใต้ Π ได้ ก็ต่อเมื่อ attribute ที่ σ ใช้ยังคงอยู่หลังการ project
ต่างจาก σA∧B(r) ≡ σA(σB(r)) ซึ่งสมมูลกัน — ต่างกันแค่ประสิทธิภาพ
C5. Πcourse_id(σyear=2026(Enrollment)) ได้กี่แถว เมื่อปี 2026 มี EN813304 สามครั้งและ EN812201 หนึ่งครั้ง
2 แถว — {EN813304, EN812201}
เพราะ relation คือเซต → Π ลบแถวที่ซ้ำออกอัตโนมัติ
ถ้าเป็น SQL SELECT course_id FROM Enrollment WHERE year=2026 จะได้ 4 แถว
ต้องเขียน SELECT DISTINCT ถึงจะเหมือน Π — ความต่างนี้ออกสอบบ่อย
DSQL — เขียน query
ใช้ฐานข้อมูล HR ชุดเดียวกับบทที่ 6 — เปิดตารางข้อมูลจริงได้ที่นี่
employees(employee_id, first_name, last_name, department, salary, hire_date, manager_id) ·
departments(department_id, department_name, location) ·
projects(project_id, project_name, start_date, department_id) ·
employee_projects(employee_id, project_id, role)
D1–D5 · WHERE predicates
-- D1. เงินเดือนเกิน 70,000
SELECT * FROM employees WHERE salary > 70000;

-- D2. เข้าทำงานระหว่าง 1 ม.ค. 2019 ถึง 31 ธ.ค. 2020
SELECT * FROM employees WHERE hire_date BETWEEN '2019-01-01' AND '2020-12-31';

-- D3. อยู่แผนก IT หรือ Finance
SELECT * FROM employees WHERE department IN ('IT','Finance');

-- D4. นามสกุลลงท้ายด้วย 'son'
SELECT * FROM employees WHERE last_name LIKE '%son';

-- D5. IT ที่ > 70000 หรือ HR ที่ < 65000
SELECT * FROM employees
WHERE (department='IT' AND salary>70000) OR (department='HR' AND salary<65000);
D6. แสดงทุกแผนกพร้อมพนักงานในแผนก รวมแผนกที่ยังไม่มีพนักงาน
SELECT d.department_name, e.first_name, e.last_name
FROM   departments d
LEFT JOIN employees e ON d.department_name = e.department;
ต้องเป็น LEFT JOIN โดยให้ departments อยู่ซ้าย ถ้าใช้ INNER JOIN แผนกที่ไม่มีพนักงานจะหายไป
D7. หาพนักงานที่เงินเดือนสูงกว่าหัวหน้าตัวเอง
SELECT e1.first_name, e1.last_name, e1.salary AS employee_salary,
       e2.first_name AS manager_first_name, e2.salary AS manager_salary
FROM   employees e1
JOIN   employees e2 ON e1.manager_id = e2.employee_id
WHERE  e1.salary > e2.salary;
Self join — ตั้ง alias สองชื่อให้ตารางเดียวกัน
D8. แสดง COUNT(*) เทียบกับ COUNT(manager_id) และอธิบายว่าทำไมต่างกัน
SELECT COUNT(*) AS all_employees, COUNT(manager_id) AS with_manager
FROM   employees;
จากข้อมูล employees 8 แถวในหัวข้อ D (ดูตารางเต็มในบทที่ 6) ซึ่ง John เป็นคนเดียวที่ manager_id เป็น NULL:
COUNT(*) นับทุกแถว = 8 · COUNT(manager_id) นับเฉพาะค่าที่ไม่เป็น NULL = 7
กฎ: aggregate ทุกตัวยกเว้น COUNT(*) จะเมิน NULL · ถ้าคอลัมน์มีแต่ NULL: COUNT → 0 · ตัวอื่น → NULL
D9. หาแผนกที่มีพนักงานมากกว่า 1 คน และแผนกที่เงินเดือนเฉลี่ยเกิน 70,000
SELECT department, COUNT(*) AS num_employees
FROM   employees GROUP BY department HAVING COUNT(*) > 1;

SELECT department, AVG(salary) AS avg_salary
FROM   employees GROUP BY department HAVING AVG(salary) > 70000;
ต้องใช้ HAVING ไม่ใช่ WHERE เพราะ WHERE ทำงานก่อน GROUP BY จึงยังไม่มีกลุ่มให้คำนวณ aggregate
D10. หาพนักงานที่เงินเดือนสูงกว่าค่าเฉลี่ยของแผนกตัวเอง
SELECT * FROM employees e
WHERE  salary > (SELECT AVG(salary) FROM employees
                 WHERE department = e.department);
Correlated subquery — inner query อ้างถึง e จาก outer query จึงถูกรันใหม่ทุกแถว
D11. หาแผนกที่ค่าใช้จ่ายเงินเดือนรวมเกิน 150,000 โดยใช้ WITH clause
WITH dept_total(dept_name, total_salary) AS
     (SELECT department, SUM(salary) FROM employees GROUP BY department)
SELECT * FROM dept_total WHERE total_salary > 150000;
D12. แสดงทุกแผนกพร้อมจำนวนพนักงาน โดยแผนกที่ไม่มีพนักงานต้องแสดงเป็น 0
SELECT d.department_name,
       (SELECT COUNT(*) FROM employees e
        WHERE e.department = d.department_name) AS employee_count
FROM   departments d;
ใช้ scalar subquery ไม่ใช่ GROUP BY — เพราะ GROUP BY บนตาราง employees จะทำให้แผนกที่ไม่มีพนักงานหายไปทั้งแถว
อีกวิธี: LEFT JOIN … GROUP BY … COUNT(e.employee_id) — ต้องใช้ COUNT(คอลัมน์) ไม่ใช่ COUNT(*) ไม่งั้นจะได้ 1 แทน 0
D13. ขึ้นเงินเดือน: ต่ำกว่า 65,000 ขึ้น 10% ที่เหลือขึ้น 5% ในคำสั่งเดียว
UPDATE employees
SET    salary = CASE WHEN salary < 65000 THEN salary * 1.10
                     ELSE salary * 1.05 END;
ทำไมต้องใช้ CASE — ถ้าเขียนสอง UPDATE แยกกัน คนที่เงินเดือนใกล้เส้นแบ่งอาจถูกขึ้นสองรอบ ขึ้นกับลำดับที่รัน
ENULL & กับดักที่ออกสอบ
E1. WHERE manager_id <> 1 ทำไมพนักงานที่ manager_id เป็น NULL ถึงหายไป
เพราะ NULL <> 1 ให้ผลเป็น UNKNOWN ไม่ใช่ TRUE
และผลของ predicate ใน WHERE ถูกถือว่าเป็น false ถ้าประเมินได้เป็น unknown → แถวนั้นไม่ถูกเลือก
แก้: WHERE manager_id <> 1 OR manager_id IS NULL
E2. เติมตารางความจริง 3 ค่าให้ครบ
OR: (unknown or true) = true · (unknown or false) = unknown · (unknown or unknown) = unknown
AND: (true and unknown) = unknown · (false and unknown) = false · (unknown and unknown) = unknown
NOT: (not unknown) = unknown
สังเกต 2 กรณีที่ตอบได้โดยไม่ต้องรู้ค่าที่หายไป: false AND unknown = false และ true OR unknown = true
E3. คอลัมน์ bonus มี 5 แถว เป็น NULL ทั้งหมด · COUNT(bonus), COUNT(*), SUM(bonus), AVG(bonus) ได้เท่าไหร่
COUNT(bonus) = 0 · COUNT(*) = 5 · SUM(bonus) = NULL · AVG(bonus) = NULL
กฎ: ถ้ากลุ่มมีแต่ค่า null ทั้งหมด → count คืน 0 · aggregate อื่นทั้งหมดคืน null
E4. ทำไม NOT IN (subquery) ถึงอันตรายเมื่อ subquery คืน NULL
x NOT IN (a, b, NULL) เทียบเท่ากับ x <> a AND x <> b AND x <> NULL
x <> NULL ให้ผลเป็น UNKNOWN เสมอ · และ true AND unknown = unknown
ผลรวมจึงเป็น UNKNOWN หรือ FALSE เสมอ ไม่มีทางเป็น TRUE → WHERE ไม่เก็บแถวไหนเลย → query คืนผลลัพธ์ว่าง
(แถวที่ค่าตรงกับตัวใดตัวหนึ่งพอดี จะได้ FALSE AND unknown = FALSE ตามตาราง E2 — ไม่ใช่ UNKNOWN
แต่ผลลัพธ์สุดท้ายก็คือถูกตัดทิ้งเหมือนกัน)
แก้: เติม WHERE col IS NOT NULL ใน subquery หรือใช้ NOT EXISTS แทน
FDatabase Design — ER Model
F1. ระบุว่าแต่ละรายการควรเป็น entity หรือ attribute พร้อมเหตุผล (โจทย์ GlobalMart)
a) Customer → E — มีข้อมูลย่อยหลายอย่างและมี customer ID ไม่ซ้ำ
b) Shipping address → E — มีข้อมูลย่อย และลูกค้าหนึ่งคนมีได้หลายที่
c) Loyalty-points balance → A — เป็นค่าเดียว ไม่มีข้อมูลย่อยลงไปอีก
d) Product Category → E — หมวดหมู่สินค้ามีหลายลำดับชั้น
e) Star rating ของ review → A — เป็นข้อมูลที่ไม่มีค่าย่อยลงมา
f) Review → E — มีทั้ง rating และข้อความ
อย่าลืมเขียนเหตุผล — ข้อสอบให้คะแนนที่เหตุผล ไม่ใช่แค่ตัว E/A
F2. วาด ER diagram Works_In ระหว่าง Employees กับ Departments พร้อมระบุ participation และ cardinality
โจทย์: พนักงานทุกคนต้องสังกัดแผนกเพียงแผนกเดียว แต่บางแผนกอาจไม่มีพนักงานเลยชั่วคราว
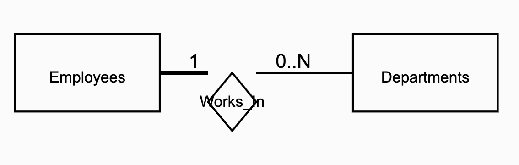
เกณฑ์ให้คะแนน (3 คะแนน):
• มี entity Employees, Departments และ relationship Works_In เชื่อม — 1 คะแนน
• ฝั่ง Employees = total participation (เส้นคู่หรือเส้นทึบ) — 0.5
• ฝั่ง Departments = partial participation (เส้นเดี่ยว) — 0.5
• cardinality ถูก: Employees = 1, Departments = N (0..N) — 1 คะแนน
คำอธิบาย (2 คะแนน): total participation แปลว่าทุกแถวใน entity จะต้องมีส่วนร่วม — พนักงานทุกคนต้องมีแผนกที่ตนเองสังกัด · partial participation แปลว่าบางแถวใน entity อาจไม่มีส่วนร่วม — บางแผนกอาจไม่มีพนักงาน บางแผนกอาจมีคนเดียวหรือมากกว่าหนึ่งคน
F3. Book–Chapter · Chapter เป็น weak entity ไหม เพราะอะไร · cardinality เท่าไหร่
โจทย์: แต่ละเล่มมีหลายบท · เลขบทไม่ซ้ำภายในเล่มเดียวกันแต่ซ้ำได้ข้ามเล่ม · บทมีอยู่ไม่ได้ถ้าไม่มีหนังสือ
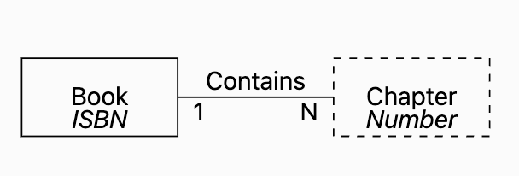
รูปในสไลด์วาดไม่ตรงกับสัญลักษณ์ที่เกณฑ์ให้คะแนนต้องการ —
ในรูป Chapter วาดเป็นกรอบเส้นประ และ Contains เป็นข้อความบนเส้น ไม่มีข้าวหลามตัด
เวลาสอบให้วาดตามสัญกรณ์ Silberschatz ที่อาจารย์สอน:
กรอบสองชั้น = weak entity · ข้าวหลามตัดสองชั้น = identifying relationship ·
เส้นคู่ = total participation · ขีดเส้นใต้แบบเส้นประ = discriminator (chapter_no)
(ดูรูปที่ถูกต้องได้ที่ บทที่ 11.5)
a) วาด diagram (2 คะแนน): Book, Chapter เป็น entity เชื่อมด้วย relationship เช่น Contains (1) · Chapter ระบุเป็น weak entity ด้วยกรอบสองชั้น (0.5) · cardinality Book (1), Chapter (N) (0.5)
b) เป็น weak entity ไหม (2 คะแนน): เป็น เพราะChapter อยู่เองไม่ได้ ต้องมีหนังสือที่ Chapter นั้นเป็นองค์ประกอบ
เหตุผลเสริม: chapter_no ไม่ซ้ำภายในเล่มเดียวกันแต่ซ้ำข้ามเล่มได้ จึงไม่มี PK ของตัวเอง ต้องพึ่ง book_id
c) cardinality (1 คะแนน): 1 : N
แปลงเป็น schema: Chapter(book_id, chapter_no, title) โดย PRIMARY KEY (book_id, chapter_no)
GER → Relational Schema
G1. เขียนกฎการแปลงทั้งหมด (ตารางสรุป)
| ER Component | Mapping |
|---|---|
| Entity | ตาราง attribute → คอลัมน์ |
| Simple attribute | 1 คอลัมน์ |
| Composite attribute | แตกเป็นหลายคอลัมน์ (ไม่ใช่ตารางใหม่) |
| Multi-valued attribute | ตารางแยกใหม่ |
| 1:1 | FK ฝั่งใดก็ได้ + UNIQUE |
| 1:N / N:1 | FK ฝั่ง "many" |
| M:N | junction table ใหม่ PK = FK ทั้งสอง |
| Ternary | ตารางใหม่ FK ทั้งสาม |
| Total participation | FK NOT NULL |
| Partial participation | FK อนุญาต NULL |
| Weak entity | FK → owner + composite PK (owner PK, discriminator) |
| Relationship attribute | อยู่กับ FK (1:N) หรือใน junction table (M:N) |
G2. เฉลยเต็ม — แปลง ER คลินิกสัตวแพทย์เป็น schema (20 คะแนน)
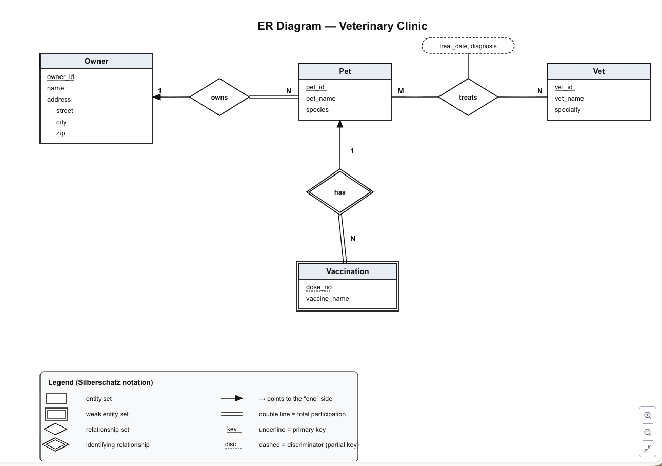
CREATE TABLE Owner (
    owner_id INT          PRIMARY KEY,
    name     VARCHAR(100) NOT NULL,
    street   VARCHAR(100),          -- composite → แตกเป็นคอลัมน์
    city     VARCHAR(50),
    zip      VARCHAR(10)
);

CREATE TABLE Pet (
    pet_id   INT         PRIMARY KEY,
    pet_name VARCHAR(50) NOT NULL,
    species  VARCHAR(50),
    owner_id INT         NOT NULL,  -- total participation
    FOREIGN KEY (owner_id) REFERENCES Owner(owner_id)
);

CREATE TABLE Vet (
    vet_id    INT          PRIMARY KEY,
    vet_name  VARCHAR(100) NOT NULL,
    specialty VARCHAR(50)
);

CREATE TABLE Treatment (           -- M:N + relationship attributes
    pet_id     INT,
    vet_id     INT,
    treat_date DATE,
    diagnosis  VARCHAR(255),
    PRIMARY KEY (pet_id, vet_id, treat_date),
    FOREIGN KEY (pet_id) REFERENCES Pet(pet_id),
    FOREIGN KEY (vet_id) REFERENCES Vet(vet_id)
);

CREATE TABLE Vaccination (         -- weak entity ของ Pet
    pet_id       INT,
    dose_no      INT,              -- discriminator
    vaccine_name VARCHAR(50) NOT NULL,
    PRIMARY KEY (pet_id, dose_no),
    FOREIGN KEY (pet_id) REFERENCES Pet(pet_id)
);
จุดหักคะแนนที่พบบ่อย: ใส่ FK แทนการสร้าง Treatment (−4) · สร้างตาราง Address แยก (−2) · Vaccination ใช้ dose_no เดี่ยวเป็น PK หรือสร้าง id ใหม่ (−2) · treat_date ไม่อยู่ใน PK (−2) · ลืม NOT NULL ที่ owner_id (−1)
G3. Student ลงได้หลาย Course และ Course มีนักศึกษาได้หลายคน · เขียน schema
M:N → ต้องสร้าง junction table
CREATE TABLE Student (
    student_id INT PRIMARY KEY,
    name       VARCHAR(100)
);
CREATE TABLE Course (
    course_id   VARCHAR(8) PRIMARY KEY,
    course_name VARCHAR(100)
);
CREATE TABLE Enrollment (
    student_id INT,
    course_id  VARCHAR(8),
    semester   CHAR(1),
    year       YEAR,
    grade      CHAR(2),           -- relationship attribute
    PRIMARY KEY (student_id, course_id, semester, year),
    FOREIGN KEY (student_id) REFERENCES Student(student_id),
    FOREIGN KEY (course_id)  REFERENCES Course(course_id)
);
ทำไมต้องมี semester และ year ใน PK — เพราะนักศึกษาคนเดิมลงวิชาเดิมซ้ำได้ในคนละภาคเรียน
(หลักการเดียวกับ treat_date ใน Treatment)
HBad Design — วิเคราะห์ปัญหา
H1. E-Commerce ที่เก็บทุกอย่างในตารางเดียว (repeating groups) มีปัญหาอะไร
Schema ที่แย่: Orders(order_id, customer_name, customer_email, product1_name, product1_price, product2_name, product2_price, …)
| order_id | customer_name | customer_email | product1_name | product1_price | product2_name | product2_price | product3_name | product3_price |
|---|---|---|---|---|---|---|---|---|
| 1001 | Somchai | somchai@gmail.com | iPhone 15 | 32000 | AirPods Pro | 8900 | NULL | NULL |
| 1002 | Malee | malee@gmail.com | iPhone 15 | 32000 | NULL | NULL | NULL | NULL |
| 1003 | Somchai | somchai_new@gmail.com | Samsung S24 | 28000 | NULL | NULL | NULL | NULL |
| 1004 | Priya | priya@gmail.com | Laptop | 45000 | Mouse | 590 | Keyboard | 890 |
ปัญหา 3 ข้อ:
- Data redundancy → update anomaly — Somchai ปรากฏในแถว 1001 และ 1003 ด้วยอีเมลต่างกัน ไม่มีทางรู้ว่าอันไหนถูก ·
ต้องแยกตาราง
customersแล้วให้ orders เก็บแค่customer_id - Repeating groups → จำนวนสินค้าจำกัดตายตัว — Priya ซื้อ 3 ชิ้นพอดี แต่ถ้าเพิ่มชิ้นที่ 4 จะเก็บไม่ได้
ต้องไปแก้โครงสร้างตาราง · ทางแก้คือแยก
order_items - ราคาสินค้าถูกเก็บซ้ำ — iPhone 15 ราคา ฿32,000 ปรากฏ 2 แถว ถ้าเปลี่ยนเป็น ฿30,000 ต้องแก้ทุกแถวที่มีสินค้านั้น
ถ้ามีแสนออเดอร์ก็ต้องแก้แสนแถว · ต้องแยก
products
ตารางที่ควรมี: customers · products · orders · order_items
(order_items คือ junction table แบบ M:N ระหว่าง orders กับ products)
H2. โรงพยาบาลที่เก็บประวัติเป็น text blob มีปัญหาอะไร
Schema ที่แย่: Patients(patient_id, name, medical_history_text)
| patient_id | name | medical_history_text |
|---|---|---|
| P001 | Wanchai | "2024-01: diagnosed diabetes type 2. prescribed metformin 500mg. 2024-06: BP high, added amlodipine 5mg" |
| P002 | Nattaya | "allergic to penicillin. 2025-03: flu. metformin 1000mg already taken for sugar" |
| P003 | Krit | "23/Jan/2025 diabetes confirmed. Nurse A updated 10:00. Nurse B updated 10:02 — overwrote Nurse A entry" |
- Query ไม่ได้อย่างเชื่อถือได้ — “หาผู้ป่วยที่ใช้ metformin ทั้งหมด” ต้องค้นสตริงในข้อความอิสระ ซึ่งพลาดได้ง่ายเพราะรูปแบบการเขียนไม่เหมือนกัน (P002 เขียนว่า “metformin 1000mg already taken for sugar”)
- ตรวจสอบข้อมูลซ้ำหรือ drug interaction ไม่ได้ — ระบบไม่มีทางรู้ว่า P002 ได้ยาตัวนี้อยู่แล้ว เพราะข้อมูลไม่ได้อยู่ในรูปแบบมีโครงสร้าง
- ไม่มี audit trail — ข้อมูลถูกเขียนทับหาย — P003 แสดงว่าพยาบาล B เขียนทับรายการของพยาบาล A ข้อมูลเดิมหายไปโดยไม่มีร่องรอย
ตารางที่ควรมี: patients · diagnoses · medications ·
prescriptions · allergies · audit_log
H3. Posts 500 ล้านแถวไม่มี index · ควรสร้าง index อะไร
Query: SELECT * FROM posts WHERE user_id = 12345 ORDER BY created_at DESC;
EXPLAIN บอกว่า type: ALL | rows: 500,000,000 | Extra: Using filesort
type: ALL = จะสแกนทั้งตาราง (แย่ที่สุด) · rows = คาดว่าต้องอ่านกี่แถว (คอลัมน์นี้ใน EXPLAIN ชื่อ
rows ไม่ใช่ rows_examined ซึ่งเป็นของ slow query log) ·
Using filesort = ต้องเรียงผลลัพธ์เพิ่มอีกรอบหลังดึงข้อมูลมา ซึ่งกินเวลาและหน่วยความจำcomposite index = index ที่สร้างคร่อมหลายคอลัมน์เรียงตามลำดับ เขียน
ON posts(a, b) —
ใช้กรองด้วย a ก่อน แล้วภายในค่า a เดียวกันข้อมูลก็เรียงตาม b ไว้ให้แล้วCREATE INDEX idx_posts_user_created ON posts(user_id, created_at DESC);ทำไมต้องเป็น composite index สองคอลัมน์ — user_id ช่วยกรอง และ created_at
ที่เรียงอยู่แล้วช่วยกำจัด "Using filesort" ทำให้ไม่ต้องเรียงผลลัพธ์ใหม่
สร้างแยกสองตัวก็ช่วยได้บ้าง แต่ composite index ตอบ query นี้ได้ครบทั้งการกรองและการเรียง
ผลกระทบถ้าไม่มี index: full table scan 500 ล้านแถวต่อการโหลด feed หนึ่งครั้ง · ถ้ามีผู้ใช้ 10,000 คนโหลดพร้อมกัน ดิสก์ I/O จะทะลุขีดจำกัด เซิร์ฟเวอร์ค้างและ query queue ยาวขึ้นเรื่อย ๆ
H4. ธนาคารที่ไม่มี transaction · เงินหายไปไหน แก้ยังไง
ตาราง accounts ตอนเริ่มต้น — โจทย์คือโอน ฿3,000 จาก Somying ไป Danai
| id | owner | balance |
|---|---|---|
| 1 | Somying | 10,000 |
| 2 | Danai | 5,000 |
รวมเงินในระบบก่อนโอน = ฿15,000 — ตัวเลขนี้ต้องไม่เปลี่ยนไม่ว่าจะโอนกี่ครั้ง
UPDATE accounts SET balance = balance - 3000 WHERE id = 1;   -- สำเร็จ: Somying เหลือ 7,000
-- เซิร์ฟเวอร์ล่มตรงนี้
UPDATE accounts SET balance = balance + 3000 WHERE id = 2;   -- ไม่เคยถูกรัน
เงิน 3,000 หายไปไหน — คำสั่งแรกทำสำเร็จและถูกบันทึกลงดิสก์แล้ว ส่วนคำสั่งที่สองไม่เคยถูกรัน เงินจึงถูกหักออกจากบัญชีต้นทางโดยไม่เคยเข้าบัญชีปลายทาง · ยอดรวมในระบบลดจาก ฿15,000 เหลือ ฿12,000
SQL ที่ป้องกันได้:
START TRANSACTION;
  UPDATE accounts SET balance = balance - 3000 WHERE id = 1;
  UPDATE accounts SET balance = balance + 3000 WHERE id = 2;
COMMIT;
-- ถ้าล่มก่อน COMMIT ระบบจะ ROLLBACK ให้อัตโนมัติ
Constraint ที่กันยอดติดลบ: CHECK (balance >= 0)
หลักการที่เกี่ยวข้อง: Atomicity — transaction ต้องทำทั้งหมดหรือไม่ทำเลย · นี่คือปัญหาที่ file system แก้ไม่ได้ และเป็นเหตุผลสำคัญที่ต้องใช้ DBMS
H5. KKU Bookstore — หาข้อบกพร่อง 6 ข้อ แล้วเขียน schema ใหม่
schema ที่นักพัฒนามือใหม่เขียนไว้:
CREATE TABLE Customer (
    ID INT PRIMARY KEY,
    FullName VARCHAR(100),           -- "นายสมชาย ใจดี"
    CompleteAddress TEXT,            -- "123 ถ.มิตรภาพ, ขอนแก่น, 40002"
    PhoneNumbers VARCHAR(200),       -- "081-111-2222,043-333-444"
    MemberStatus VARCHAR(50),        -- พิมพ์อะไรลงไปก็ได้
    Age INT,                         -- ตอนนี้มีแถวที่ Age = 250
    RegDate VARCHAR(20)              -- "22/6/2026" เก็บเป็นข้อความ
);| # | ปัญหา | Concept |
|---|---|---|
| 1 | Customer เอกพจน์ · ID, FullName เป็น CamelCase | naming convention |
| 2 | FullName รวมคำนำหน้า ชื่อ นามสกุล | composite attribute |
| 3 | CompleteAddress รวมถนน เมือง รหัสไปรษณีย์ | composite attribute |
| 4 | PhoneNumbers เก็บหลายเบอร์คั่นจุลภาค | multi-valued attribute — ละเมิด 1NF |
| 5 | MemberStatus ไม่จำกัดค่า · Age รับ 250 ได้ | domain constraint |
| 6 | RegDate เก็บวันที่เป็น VARCHAR | data type |
CREATE TABLE customers (
    customer_id       INT PRIMARY KEY,
    name_title        VARCHAR(10),
    first_name        VARCHAR(50) NOT NULL,
    last_name         VARCHAR(50) NOT NULL,
    street_address    VARCHAR(200),
    city              VARCHAR(50),
    postal_code       VARCHAR(10),
    age               INT CHECK (age BETWEEN 16 AND 100),
    member_status     VARCHAR(10) NOT NULL DEFAULT 'regular'
                      CHECK (member_status IN ('regular','silver','gold')),
    registration_date DATE NOT NULL
);

CREATE TABLE customer_phone_numbers (
    phone_id     INT PRIMARY KEY,
    customer_id  INT NOT NULL,
    phone_number VARCHAR(20) NOT NULL,
    phone_type   VARCHAR(10) CHECK (phone_type IN ('mobile','home','office')),
    is_primary   BOOLEAN DEFAULT FALSE,
    FOREIGN KEY (customer_id) REFERENCES customers(customer_id)
);
เช็กลิสต์สุดท้ายก่อนเข้าห้องสอบ
- NULL ในการเปรียบเทียบ —
<>ตัดแถว NULL ทิ้ง ·= NULLใช้ไม่ได้ - Π ตัดแถวซ้ำ แต่ SELECT ไม่ตัด — ต้องใส่ DISTINCT เอง
- WHERE ใช้ aggregate ไม่ได้ — ต้องใช้ HAVING
- M:N ต้องสร้างตารางใหม่ — ใส่ FK เฉย ๆ ไม่ได้ (−4 คะแนน)
- เส้นคู่ = NOT NULL · กรอบสองชั้น = composite PK
- > ANY → > MIN · > ALL → > MAX
- r ∩ s = r − (r − s)
- FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY
- candidate key = minimal superkey
- aggregate ทุกตัวยกเว้น COUNT(*) เมิน NULL
- weak entity PK = (owner PK, discriminator)