ชีทสรุป
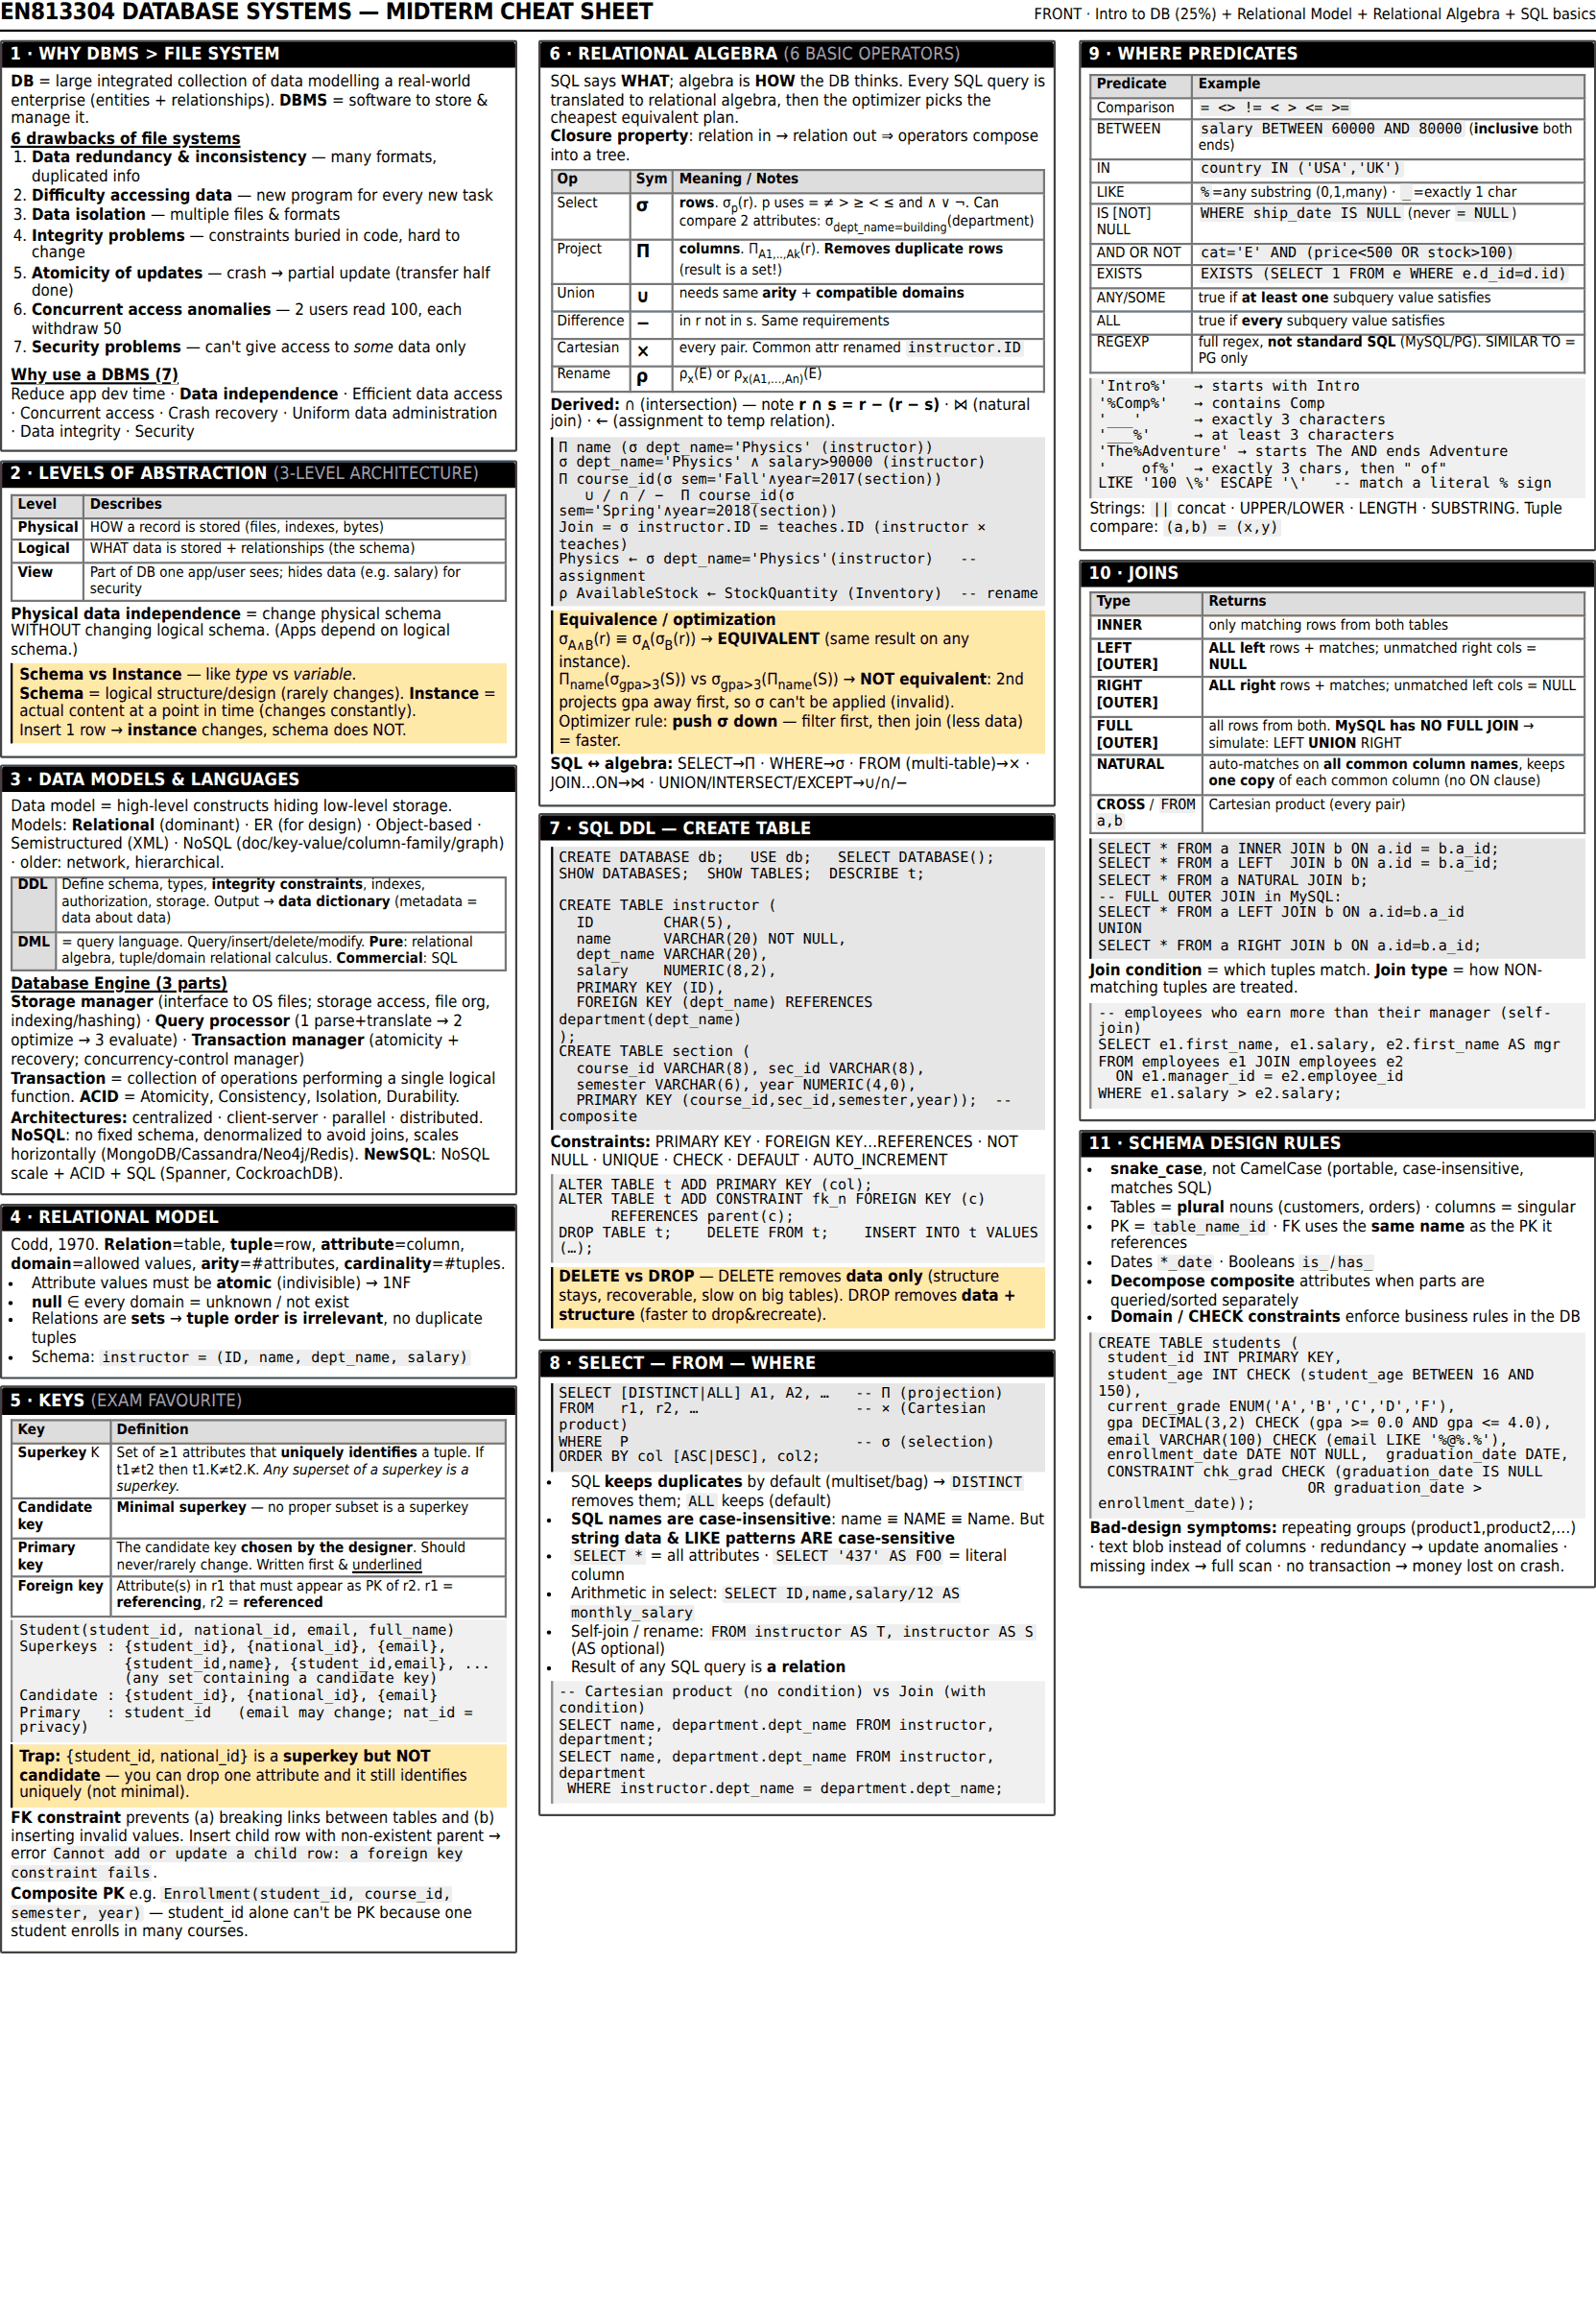
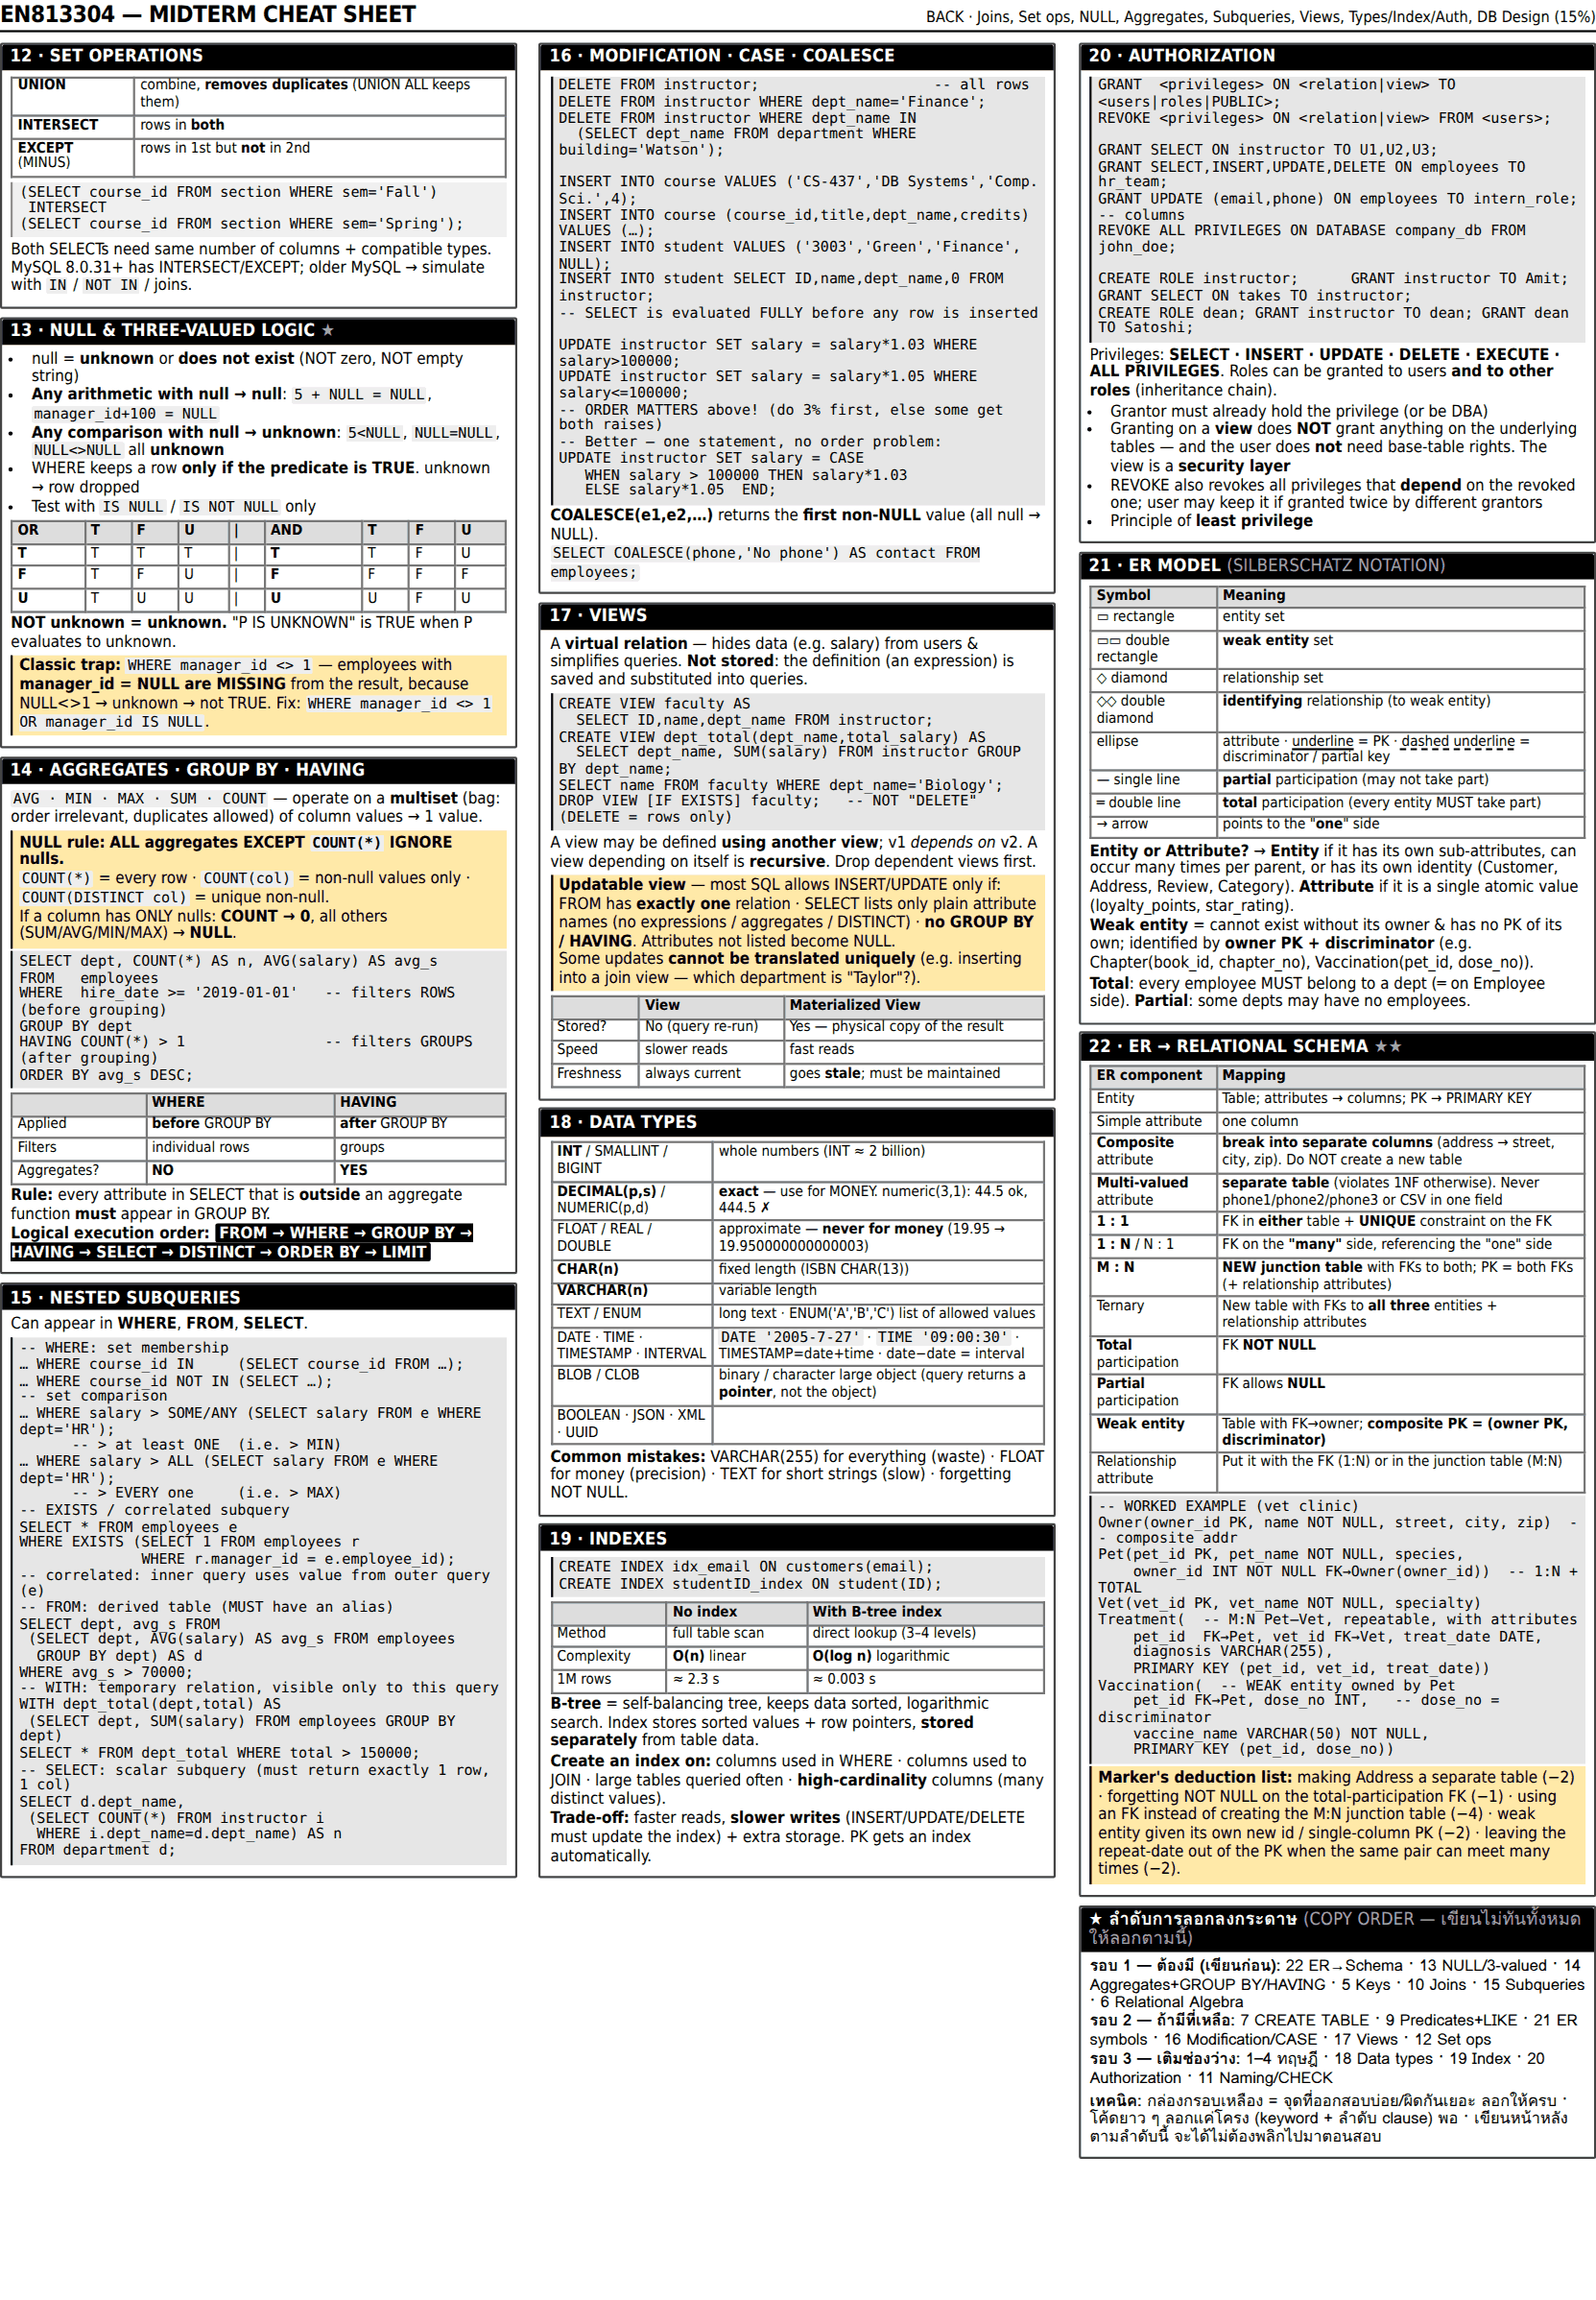
ชีท 1 แผ่น 2 หน้า
จัดไว้ให้ครบทุกหัวข้อที่ออกสอบ ในพื้นที่ A4 สองหน้าพอดี — เปิดไฟล์ PDF แล้วลอกลงกระดาษด้วยลายมือ (กฎห้องสอบ: ต้องเขียนมือบนกระดาษจริง ห้ามพิมพ์ ห้ามปรินต์ ห้ามเขียนบน iPad)
ลำดับการลอก — ถ้าเขียนไม่ทันทั้งหมด
รอบที่ 1 (ต้องมี): ER→Schema · NULL/ตรรกะ 3 ค่า · Aggregates + GROUP BY/HAVING · Keys · Joins · Subqueries · Relational Algebra
รอบที่ 2 (ถ้ามีที่เหลือ): CREATE TABLE · Predicates + LIKE · ER symbols · Modification/CASE · Views · Set operations
รอบที่ 3 (เติมช่องว่าง): ทฤษฎีบทที่ 1–4 · Data types · Index · Authorization · Naming/CHECK
เทคนิค: กล่องกรอบเหลืองในชีท = จุดที่ออกสอบบ่อยหรือคนผิดกันเยอะ ลอกให้ครบ · โค้ดยาว ๆ ลอกแค่โครง (keyword + ลำดับ clause) พอ · เขียนหน้าหลังตามลำดับนี้ จะได้ไม่ต้องพลิกไปมาตอนสอบ
หน้า 1Intro to DB · Relational Model · Relational Algebra · SQL basics · Joins
หน้า 2Set ops · NULL · Aggregates · Subqueries · Views · Types/Index/Auth · Database Design
สรุปสั้นแบบอ่านบนจอ
ถ้าอ่านบนมือถือแล้วรูปเล็กเกินไป ใช้เวอร์ชันข้อความด้านล่างแทนได้
Keys
| Superkey | เซตของ attribute ≥1 ตัวที่ระบุ tuple ได้เฉพาะตัว · ถ้า K เป็น superkey แล้ว superset ของ K ก็เป็น superkey |
| Candidate key | minimal superkey — ไม่มีสับเซตแท้ตัวใดเป็น superkey |
| Primary key | candidate key ที่ผู้ออกแบบเลือก · ควรเป็นค่าที่ไม่เปลี่ยน |
| Foreign key | attribute ใน r₁ ที่ค่าต้องปรากฏเป็น PK ใน r₂ · r₁ = referencing, r₂ = referenced |
Relational Algebra — 6 basic operators
| Op | ความหมาย |
|---|---|
| σ | Select — กรองแถว · = WHERE |
| Π | Project — เลือกคอลัมน์ · ลบแถวซ้ำอัตโนมัติ |
| ∪ | Union — ต้อง arity เท่ากัน + domain เข้ากันได้ |
| − | Set difference |
| × | Cartesian product — ทุกคู่ |
| ρ | Rename |
| ∩ · ⋈ | derived — r ∩ s = r − (r − s) · join = σ(r × s) |
ลำดับการทำงานของ SQL
FROM → WHERE → GROUP BY → HAVING → SELECT → DISTINCT → ORDER BY → LIMIT
นี่คือเหตุผลที่ WHERE ใช้ aggregate ไม่ได้ และ ORDER BY ใช้ alias จาก SELECT ได้
นี่คือเหตุผลที่ WHERE ใช้ aggregate ไม่ได้ และ ORDER BY ใช้ alias จาก SELECT ได้
JOIN
| INNER | เฉพาะแถวที่จับคู่ได้ทั้งสองฝั่ง |
| LEFT | ทุกแถวซ้าย · ฝั่งขวาที่ไม่มีคู่ = NULL |
| RIGHT | ทุกแถวขวา · ฝั่งซ้ายที่ไม่มีคู่ = NULL |
| FULL OUTER | ทุกแถวทั้งสองฝั่ง · MySQL ไม่มี → LEFT UNION RIGHT |
| NATURAL | จับคู่อัตโนมัติจากชื่อคอลัมน์ร่วมทุกตัว · เก็บคอลัมน์ร่วมชุดเดียว |
NULL
- เลขคณิตกับ NULL → NULL เสมอ (
5 + NULL = NULL) - เปรียบเทียบกับ NULL → UNKNOWN เสมอ (แม้แต่
NULL = NULL) - WHERE เก็บแถวเฉพาะเมื่อผลเป็น TRUE · UNKNOWN → ทิ้ง
- ตรวจด้วย
IS NULL/IS NOT NULLเท่านั้น - false AND unknown = false · true OR unknown = true · NOT unknown = unknown
- aggregate ทุกตัวยกเว้น COUNT(*) เมิน NULL · มีแต่ NULL → COUNT = 0, ตัวอื่น = NULL
Subquery
- > ANY / SOME ≡ > MIN · > ALL ≡ > MAX
- = ANY ≡ IN · <> ALL ≡ NOT IN
- NOT IN + NULL = อันตราย → คืนผลว่าง · ใช้ NOT EXISTS แทน
- Correlated subquery = inner อ้างถึง outer → รันซ้ำทุกแถว
- Derived table ใน FROM ต้องมี alias
ER → Schema
| Composite attribute | แตกเป็นหลายคอลัมน์ (ไม่ใช่ตารางใหม่) |
| Multi-valued attribute | ตารางแยกใหม่ |
| 1 : 1 | FK ฝั่งใดก็ได้ + UNIQUE |
| 1 : N / N : 1 | FK ฝั่ง "many" |
| M : N | junction table ใหม่ PK = FK ทั้งสอง (+ relationship attributes) |
| Ternary | ตารางใหม่ FK ทั้งสาม |
| Total (เส้นคู่ ═) | FK NOT NULL |
| Partial (เส้นเดี่ยว —) | FK อนุญาต NULL |
| Weak entity (กรอบสองชั้น) | PK = (PK ของ owner, discriminator) |